IN 3 LINES
- 自分たちのゲームは勝率32%。作り手が思うより、ずっと難しすぎた。
- 残り体力と勝敗から「次はどれくらいの強さがいいか」のルールを作り、直近5回の戦績から難易度を予測するAIを学習させた。
- よく当たる一方で、上手い人ほど易しく出てしまう弱点が見えた。正解のルール自体を疑うところまでが研究だった。
01 — PROBLEM
189回のうち、勝てたのは60回だけだった
DOG SQUAD は、犬を操作して自分の家をリスの群れから守る、ブラウザで遊べる3Dタワーディフェンスゲームです。Three.js で描き、効果音や BGM は Web Audio API でその場で作っています。
作り手としては歯ごたえのある難易度にしたつもりでしたが、遊ぶ人にとっては難しすぎたのです。難易度は最初に自分で選べる作りでしたが、自分の腕前に合う設定を選べる人はほとんどいませんでした。
02 — IDEA
人が選ぶのをやめて、ゲームが腕前に合わせる
そこで、プレイ結果から次の難易度を自動で調整する動的難易度調整(DDA)を取り入れることにしました。
負けたら簡単にする
ギリギリ勝てる手応えを保つ
負けたら易しくするだけだと、上手な人には退屈になります。「ギリギリ勝てる、一番楽しい手応え」をどう数字にするかが、この研究の鍵でした。
03 — LABEL
「ちょうどいい」のルールを設計する
クリア時の残り体力と勝敗から、次回の敵の強さの倍率を決める教師データを自分たちで設計しました。
白熱したいい勝負。今の強さを保つ。
余裕がありすぎるので、敵を強くする。
運がよかった可能性もあるので、少しだけ易しく。
挫折しないように、再挑戦しやすくする。
04 — MODEL & RESULT
学習させて、グラフを読む
直近5回分の戦績とスコアを特徴量にして、軽量なニューラルネットワークで学習させました。
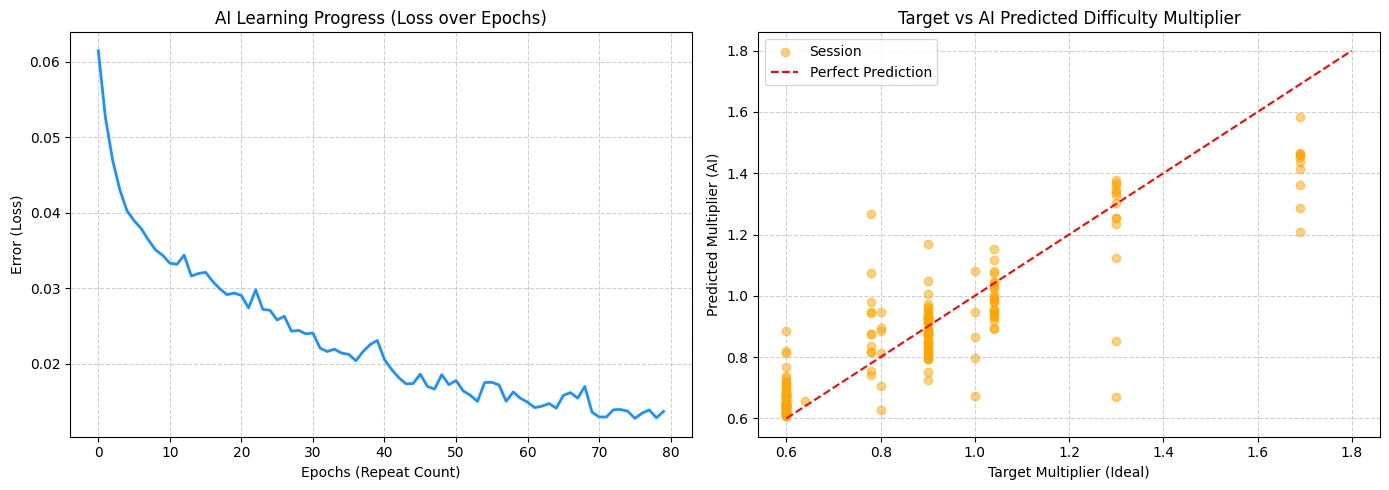
左:誤差はどう下がった?
最初の20回ほどで 0.06 から 0.03 あたりまで一気に下がり、80回目で 0.013 付近に落ち着きました。後半のギザギザは学習率を下げずに回しているせいですが、下がりきったあとに跳ね上がってはいないので、過学習の手前で止められていると判断しました。
右:点が縦の帯に分かれているのはなぜ?
倍率が 1.3 倍や 0.6 倍のかけ算で積み上がるので、取りうる値がとびとびになるためです。1.0 前後の帯はよく当たっていました。
どこで外れた?
外れているのは両端です。とくに右端の 1.7 付近では、予測がほぼ全部点線より下。強くしていいと教えているのに、AI は控えめな数字しか出していません。
理由はデータの数だと考えています。3回連続で完勝して倍率が 1.7 まで積み上がるような記録はごく少数で、数の少ない値は平均に引っぱられます。いちばん歯ごたえを求めている上手い人に、いちばん効きが弱いという結果になりました。
05 — LIMIT
正解そのものを疑う
ここまでの精度は「教師データにどれだけ近づけたか」でしかありません。その教師データは、残り体力で場合分けした自分たちの手作りのルールです。つまりモデルが上手くなるほど、私たちが決めた線引きを忠実になぞるだけになります。
体力を20%残して勝った人が本当に楽しかったのかは、体力の数字からは分かりません。確かめるには、遊んだ人に面白かったかを聞いて、その答えを正解として学習させる必要があります。
06 — WHAT I LEARNED
学んだこと
- まずデータを見る「歯ごたえがある」は作り手の感覚でした。勝率32%という数字を見て、初めて遊ぶ人とのずれに気づけました。
- 少ないデータは平均に負ける精度の数字だけ見ると良くても、数の少ない端のケースで外れる。どこで外れているかを見ることが大事でした。
- いちばん難しいのは「正解」の定義モデルより先に、何を正解とするかで結果が決まる。最後までそこに戻ってきました。
ここまで読んでくださって、
ありがとうございました。